第 1 章 全栈工程师的认知地图
副题:业务、技术、工程三条线的交汇
本章是全书的地图章:先回答"全栈"到底是一种什么能力,再摊开本书这张地图,最后交代这本书给你什么、不给你什么,以及怎么用。
本章要建立的认知
- "全栈"指的是"看得懂一个系统 + 能从业务出发做技术决策",跟掌握的名词多少没关系;
- 本书的地图长什么样:一条业务主线、两条观察线(技术、工程),由一个贯穿案例钉在一起;
- 本书重点讲什么、不展开讲什么,以及为什么这样取舍。
1.1 你的知识为什么连不起来
先想象一次普通的面试复盘。面试官问:你们的接口为什么加了一层缓存?你答:因为快。再问:为什么是 Redis 而不是别的?缓存和数据库不一致了怎么办?什么时候这层缓存就该被拆掉了?换个话题再问:接口返回前为什么要过一层 DTO,直接把数据库结果丢给前端不行吗?五个问题下来,你会发现"用过某技术"和"懂它在系统里的位置"是两回事。
如果你有 1-3 年开发经验,这种体验多半不陌生。你写过接口、建过表、部署过服务,主流名词都见过。但名词在你的脑子里是点状的:每个点单独认识,点与点之间没有连线。换个说法——你手里有一摞城市地标的明信片,却没有地图:每张明信片都精美,但你不知道两站之间怎么走,更不知道这座城市为什么这样规划。
本书给这种状态起了个名字,叫名词清单:知道有什么技术,不知道它们为什么在那里、彼此怎么连通。
名词清单不是你的错,是学习方式造成的。教程按工具组织——学 React 的教程不负责告诉你 MySQL 的事;面试按名词出题——"Redis 有哪些数据结构"考不出"你的业务该不该上缓存"。工具永远学不完,名词清单会越拉越长,而"点状"这个根本问题留在原地。
名词已经够多了,缺的是连线。而连线只有一种可靠来源:决策——绝大多数技术都是为了回应一个具体业务问题才被放进系统的,顺着这个"为什么",名词就连成了网。这就是本书标题里"地图"的含义:一张由决策连起来的技术地图。
这张地图有两种用法。读别人的系统时反推:从眼前这套技术栈出发,问它当时遇到了什么问题,才把这些技术逼到一起。设计自己的系统时正推:从业务问题出发,问这里该选什么、为什么是它。一反一正,后面的章节会反复用到——第 5 章会把这两个方向收敛成同一个可以走一遍的模型。
1.2 "全栈"到底是一种什么能力
"全栈工程师"这个词有误导性。字面像是"整个技术栈都精通",照这个理解去努力,常见的两条路都走不通:
- 语言全家桶:Vue、React、Flutter 轮着学,每个都停在入门;
- 全干工程师:前后端测试运维一人包办,广度换深度,什么都浅。
业界接受度更高、也更准确的说法,是 Valve 员工手册里的 T 型人才:横杠是广度——看得懂系统各部分、知道上下游在发生什么;竖杠是深度——至少一个领域扎得足够深,深到能独立判断对错。稀缺的不是"每样会一点",而是"一处能判错,全局能看懂"。技术社区还有句老话:全栈是瑞士军刀,样样能开;专才是削铁如泥的宝剑,一击致命。两种路线没有对错,本书不为任何一方站队。
本书不承诺把你培养成 T 型人才——那是职业路径,不是一本书的任务。本书只负责把 T 型那根横杠立起来。立起来的标准,一句话:
读完本书,你不一定能熟练使用所有 Web 技术,但应该能够看懂一个 Web 系统、解释它为什么这样设计,并能够从业务需求出发做出基本的技术方案。
这是本书的最终目的:看懂一个系统由什么组成、解释它为什么这样设计、面对一个业务需求时做出基本的技术方案。三件事层层递进——看得懂才能解释,解释得了才做得出判断。这句话同时是你合上书之后的自测标准:看看自己长出的是判断力,还是只是一张更长的名词清单。
所以本书要画的是一张决策地图。名词清单上,Redis 是一行孤立的名字;决策地图上,Redis 是一个路口——为什么修在这、通向哪、堵车了怎么办,全部标注。地图上每个名词背后都是一串决策:业务为什么遇到这个问题 → 业界为什么这样解决 → 它内部怎么工作 → 它解决了什么、付出了什么代价——以及业务再走一步,还要不要重新评估。
从名词清单到决策地图,就是这本书要陪你走完的一次升级。
1.3 地图的骨架:三条线和一个案例
一个 Web 系统从出生到长大,始终在跑三条线:
业务线(主线):一个业务系统的完整生命周期——需求、设计、开发、测试、发布、运行、迭代。它回答"系统为什么长成这样":业务每前进一步,就逼出一个新的技术问题。用户多了,接口慢了;开始收钱了,不能出错了;团队大了,交付跟不上了。系统里绝大多数技术都是业务逼出来的,不是开发者的心血来潮。理解了这条线,就理解了技术的动机。
技术线(运行时视角):一次请求从用户指尖到屏幕背后经历的一切——浏览器、DNS、CDN、HTTP、服务端、数据库、缓存。它回答"技术怎么支撑业务",是观察"系统由什么组成、一次操作发生了什么"的工具。
工程线(工程生命周期视角):代码从"一个人写的"变成"多人协作、稳定交付、持续运行的产品"所经历的一切——测试、构建、CI/CD、部署、监控、架构演进。它回答"怎么让能跑的代码变成能一直跑的产品"。
三条线不是三本书,它们交汇在同一个东西上:一个具体的业务系统。为了不让你对着抽象地图发懵,本书准备了一个贯穿案例——一个最小的社区交易产品:有人发内容,有人评论,有人上架商品,有人下单付款。全书只保留六个核心对象:用户、内容、评论、商品、订单、支付。六个对象不是随意挑的——内容与评论撑起社区的日常,商品与订单引出交易,支付把业务和金钱连在一起;后面每一章的技术问题,几乎都从这六个对象的关系里长出来。案例从一个想法起步,跟着业务一路长到规模化系统。
案例按五阶段成长:想法期 → 用户增长 → 交易增长 → 团队增长 → 规模增长。每个阶段逼出一批技术——全书原则"业务逼出技术",就在案例的成长里一幕幕上演。
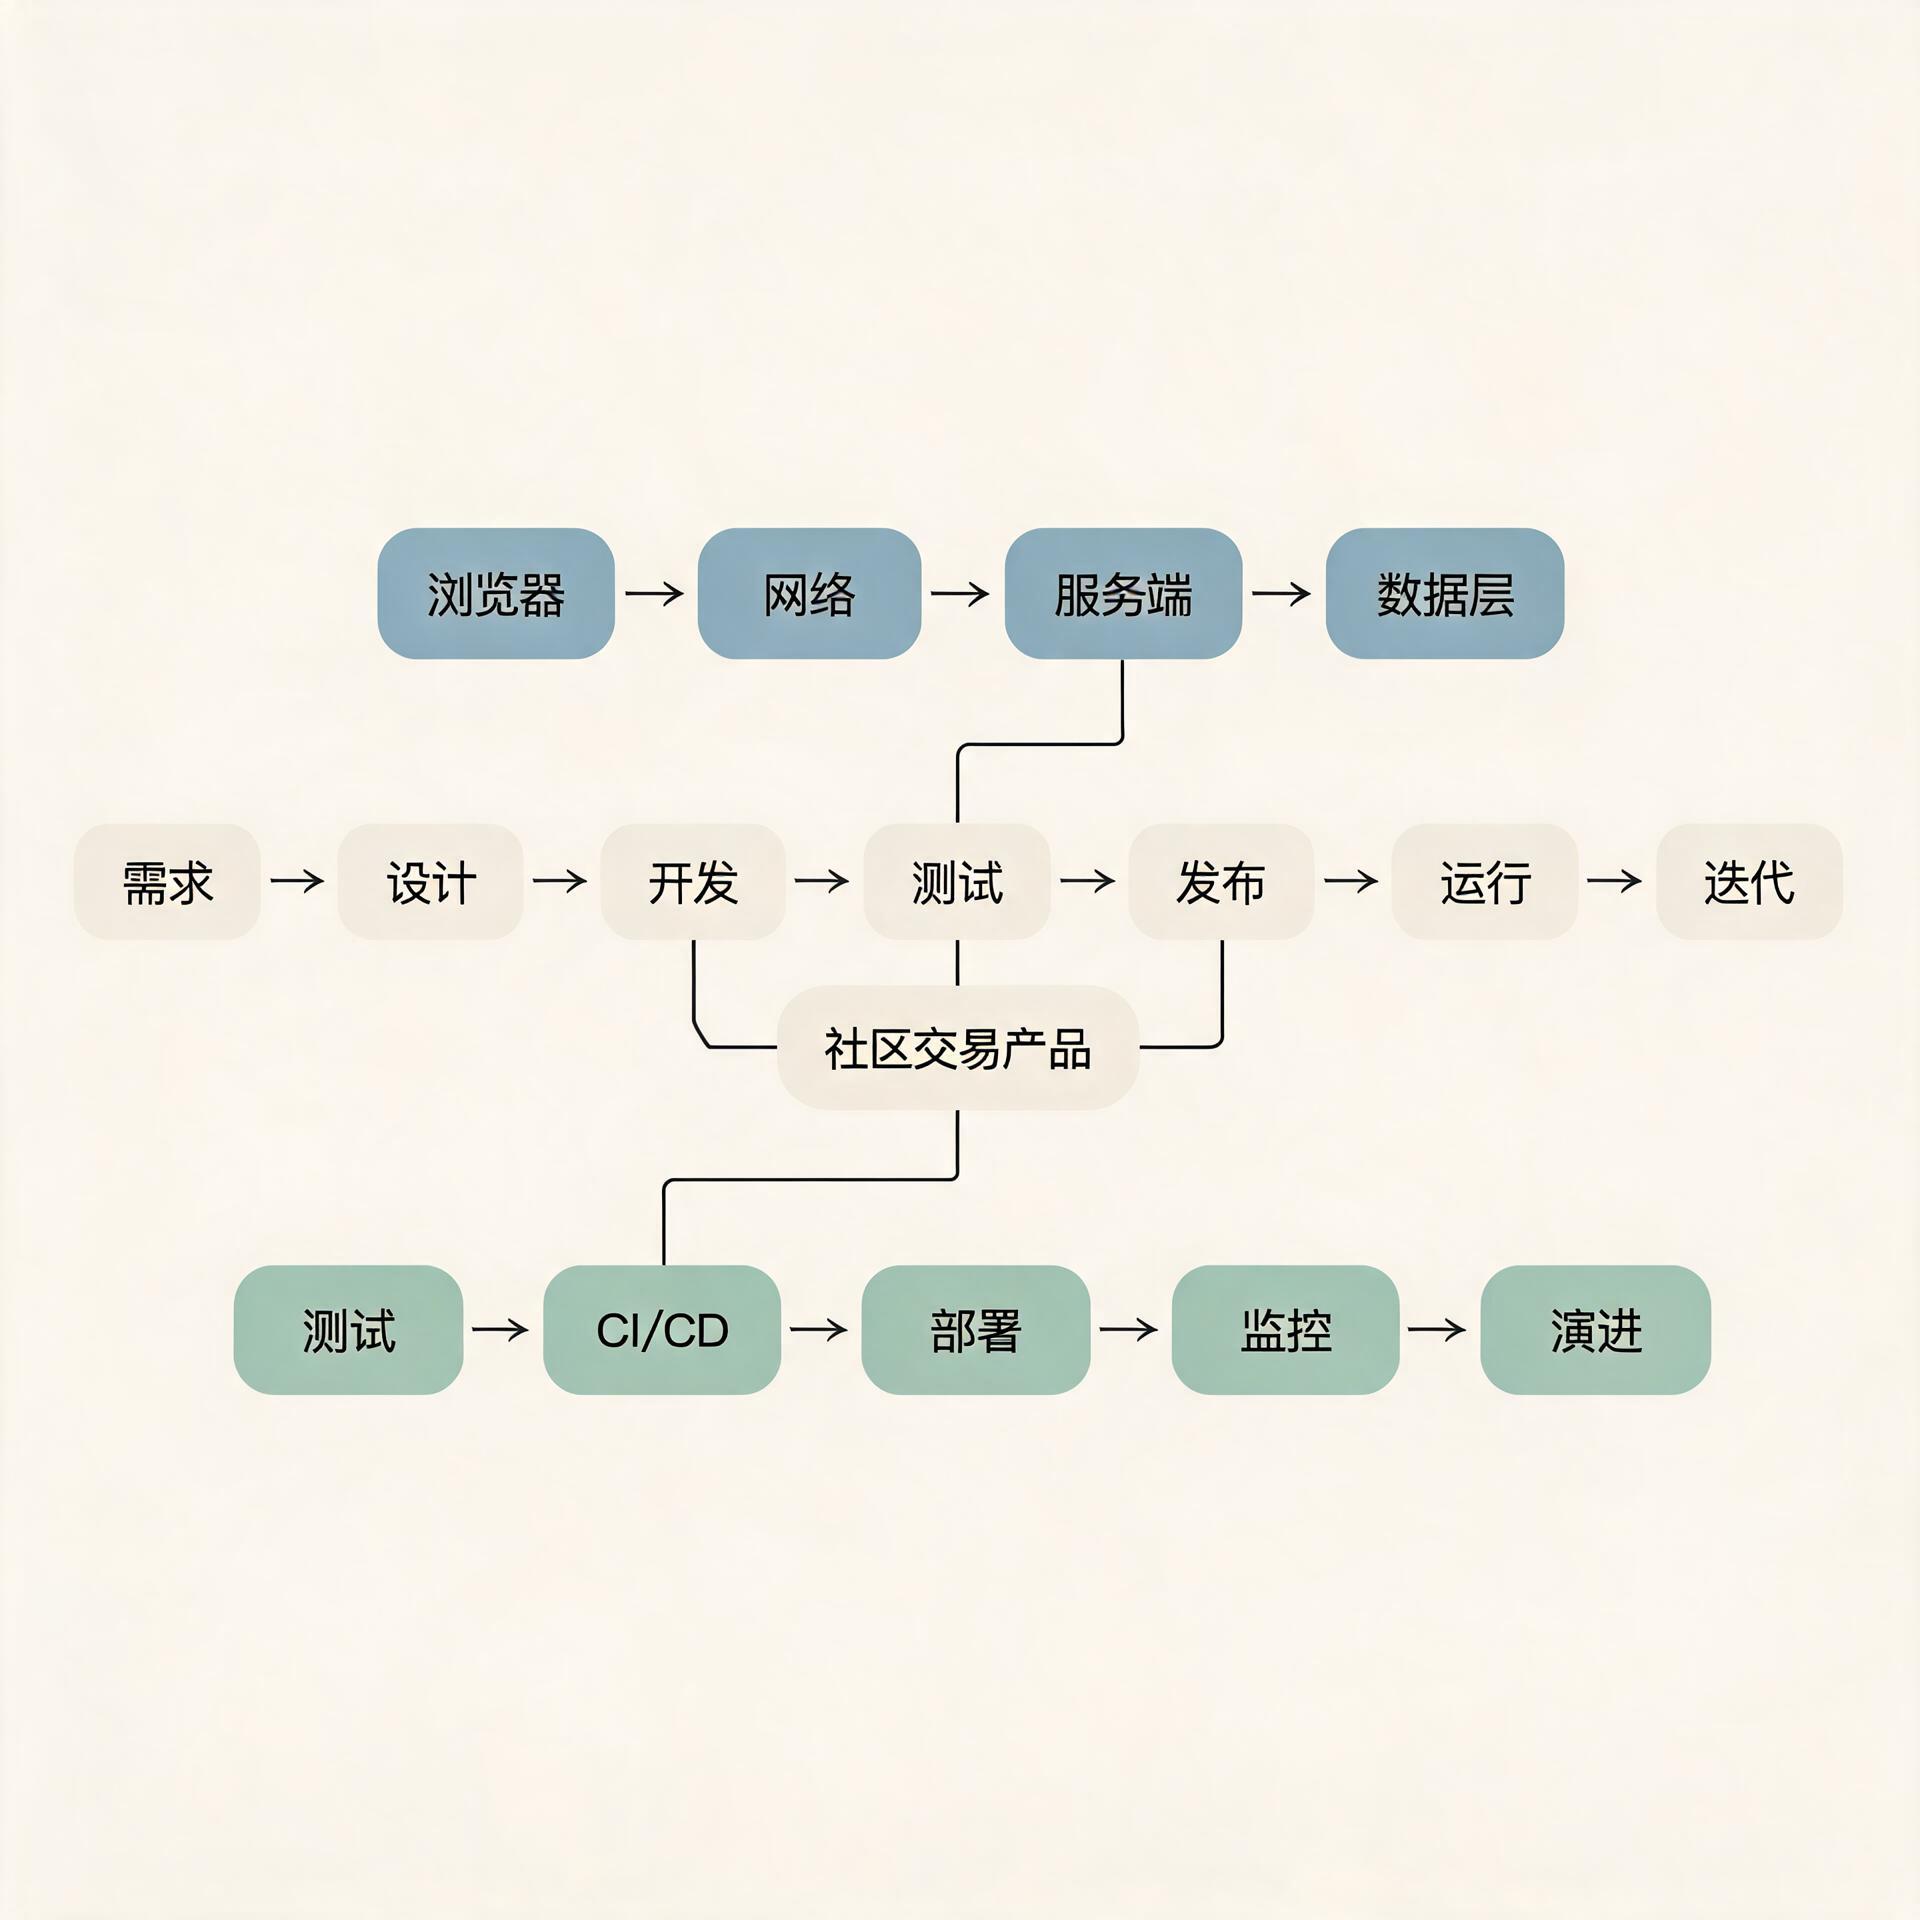
三条线交汇,全书都是它的放大
这张图是全书第一张图,也是全书需要反复回看的核心图之一。后面很多章节都会把它放大——第 8 章放大"浏览器",第 14 章放大"数据层",第 22 章放大"CI/CD"。看的时候先找主轴——横着的那条业务线——再沿主轴上下找两条观察线;往后每读一章,都可以用这个方式定位:这一章在地图的哪个位置。你读到的是同一张地图的不断放大,不是一批互不相干的插图。
关于案例,提前声明一个原则:案例只回答"业务发展到什么阶段、什么问题逼出了这个技术",不回答"这个产品用没用到某技术"。书里没出现某个流行框架,不代表它不好,只代表地图上的问题没把它逼出来——技术服务于案例,案例不服务于技术。案例是载体,不是边界——你从它身上学到的是"业务问题如何逼出技术"的方法,这套方法换成任何业务都成立。
1.4 决策地图怎么读:四个问题和一张表
本书看每一项技术,都走同一条路,四个问题:
- 业务为什么遇到了这个问题——案例走到哪一步,用户或团队碰上了什么具体麻烦;
- 为什么产生这种技术方案——业界怎么解决,为什么是这个形态而不是别的;
- 这个技术内部到底怎么工作——核心概念与关键机制,深到能解释"为什么"为止;
- 它解决了什么,又付出了什么代价——收益与代价成对出现,边界在哪,业务再走一步要不要重新评估。
每次走完四步,会沉淀出一张本书最有辨识度的表格——业务-技术对应表。书中每一章的内容就是按这个顺序走的,对应表把一整章的论证压成四列:业务诉求、技术选择、为什么、代价/取舍。参考下表:
| 业务诉求 | 技术选择 | 为什么 | 代价/取舍 |
|---|---|---|---|
| 一个人快速把想法验证上线 | 单体架构 + PostgreSQL | 结构最简单、改动最快,适合人手少的阶段 | 规模上来后拆分成本高,需要提前留边界 |
| 用户变多,首页越来越慢 | 加缓存(如 Redis) | 热数据就近读,给数据库减负 | 引入缓存失效与一致性问题,需要额外机制 |
这张表有个固定读法:先读"业务诉求"——技术永远从这里出发;再读"为什么"——那是每章正文的主体;最后读"代价/取舍"——这是本书与多数同类书分岔的地方,会做决策的人,得先明白自己准备付出什么。
到第 5 章时,这四步会展开为更详细的九步决策模型:业务目标 → 业务约束 → 技术问题 → 候选方案 → 评价维度 → 方案选择 → 收益 → 代价 → 未来演进条件。业务中的关键技术选择——Session 还是 JWT、SQL 还是 NoSQL、要不要缓存、要不要消息队列、要不要微服务——都会按这个模型走一遍。
本书的重点是把这张地图讲清楚,不是带你搭工程。所以书中展示的代码都是概念的证据:最小的报文、一段 SQL、一个状态机、一次幂等判断,不保证能直接运行,也不凑成完整工程。它们存在的理由是"这段代码比一百句解释更能讲清一个概念"。
1.5 本书包含什么,不包含什么
本书重点讲五件事:
- 原理:核心技术是什么、内部如何运转——渲染管线、HTTP、数据库索引、CI/CD 链路;
- 架构:系统由哪些部分组成、为什么这样组织,而不是某个组件的操作步骤;
- 业务:业务问题如何翻译成技术问题,业务语言如何变成技术语言;
- 工程:测试、交付、运维如何守住"业务正确"的底线;
- 技术决策:为什么选 A 不选 B,A 的代价是什么。
不展开讲:
- 某框架的完整 API——查文档更快;
- 某语言的完整语法——语法书更厚;
- 某云厂商的产品操作手册——界面会更新,手册会过时;
- 某框架的最佳实践大全——本书只讲最佳实践背后的原理,不讲清单本身;
- 从零写出一个完整商业项目的全套代码——本书不造教学项目。
这些都是在帮你看懂系统、解释设计、做出方案。所以你会看到"为什么是这个数据库、它在决策模型里的位置",看不到安装步骤;你会理解缓存为什么存在、失效策略为什么这样定,看不到"缓存最佳实践二十条"。这是一本讲"为什么"的书,不是讲"怎么点"的书,毕竟技术过时得很快。
如何读这本书:
- **建议按顺序读。**案例从第 3 章正式开场,业务每前进一步,逼出的技术问题就交给后面的章节处理,跳读会错过这条主线。
- **每章先读业务-技术对应表,再读正文。**对应表是这一章的认知压缩——先看它,正文就有了骨架;读完再回头确认每一行都真懂。
- **跟着案例走。**五阶段是全书的时间线,每章都锚在某个阶段。读时问自己:业务现在走到哪了?什么问题逼出了这章的技术?
- 陌生名词不必当场查透,先把握全局感。
- 最好带一个问题进来:你手头维护的项目,在地图的哪条线、哪个阶段?每一章的对应表都试着替你的项目填一遍——填不上的那行,就是你的认知缺口。
- 书末附录还有案例的完整技术方案存档——需求文档、架构图、关键代码、上线记录,它是全书唯一一处"完整工程":正文里那些概念的证据(最小的报文、一段 SQL、一个状态机),都能在附录里看到它们在真实系统中的完整样子。想看"一张地图从第 3 章到第 27 章累积成什么样",从附录倒着读最直观。
我们再来摊开看一下整张地图的形状——全书的地图(图 1-2):七个部分,一段旅程——认知准备(第 1-3 章)把地图交到你手上;需求与设计(第 4-7 章)把业务翻译成技术;开发实现(第 8-15 章)沿一次请求走完整个技术线;性能、交易、安全与质量(第 16-20 章)处理业务成长与碰钱后的硬承诺;发布与部署(第 21-23 章)沿工程线把产品送上线;运维与迭代(第 24-27 章)看业务成长的下半场;收束(第 28 章)把地图变成你自己的能力。
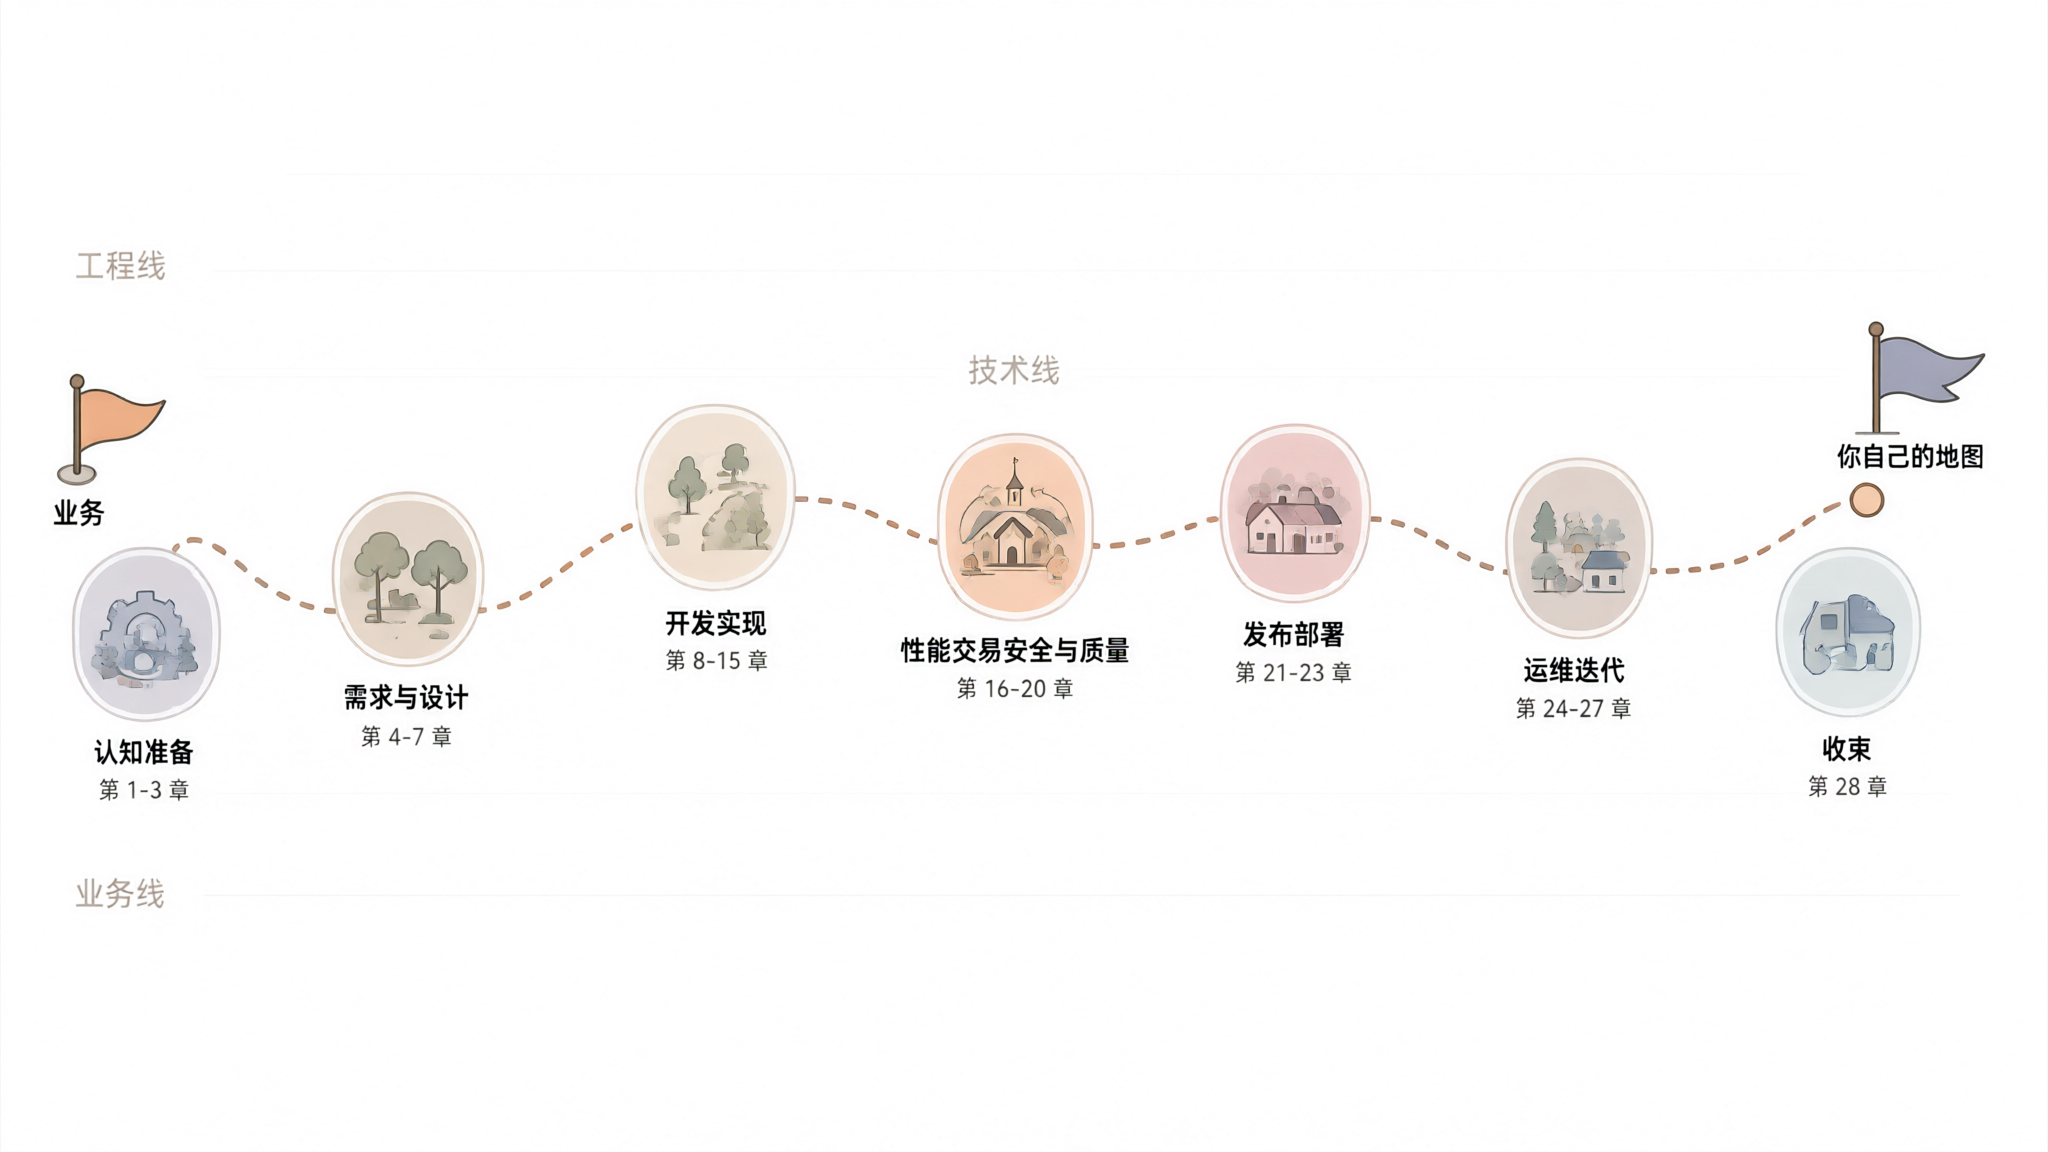
七部分 = 三条线的三段旅程
整本书的结构是一条业务线,不是名词分类目录——先给地图,再走技术线,处理增长与商业化,送产品上线,看演进,最后收束回你自己。这是本书与"技术名词大全"类书籍最本质的区别。
本章小结
这一章只做了一件事:把地图交给你。
- "全栈"是看懂系统与做决策的能力,不是名词背了多少;本书要带你从名词清单走到决策地图;
- 地图上有三条线:业务主线(系统为什么长成这样)、技术线(技术如何支撑业务)、工程线(如何稳定交付);
- 一个社区交易产品贯穿全书,把三条线钉在地图上;每项技术都走"业务 → 技术 → 原理 → 取舍 → 演进"的闭环;
- 本书重点讲原理、架构、业务、工程与决策,不展开讲 API 大全、语法手册与最佳实践合集。
下一章
地图摊开之后,还有一个问题悬着:地图上为什么会有这么多技术?今天用单体,明天拆微服务;今天用 Session,明天换 JWT——它们为什么一直在变?
技术变化多半不是在追赶潮流,而是决策的产物——变了,就有原因。下一章,我们看技术为什么会不断变化。